Pagination SEO: So bleiben mehrseitige Inhalte crawlbar und indexierbar
Pagination ist SEO-verträglich, wenn jede Seite einer Serie eine eigene, eindeutige URL erhält und per Canonical auf sich selbst verweist. Fragment-IDs und reine JavaScript-Navigation ohne echten Link gehören nicht in die Umsetzung. Rel=next/prev beeinflusst die Indexierung schon länger nicht mehr. View-All, Load-More und Infinite Scroll funktionieren als Alternativen, aber nur mit sauberem URL-Konzept.
Saubere Pagination für bessere Sichtbarkeit
SEYBOLD ONE analysiert technische SEO-Probleme und entwickelt datengetriebene Strategien für nachhaltige Suchmaschinen- und KI-Sichtbarkeit.
Unverbindliche Beratung anfragenWelches UX-Muster passt: Paginierung, Mehr Laden, Unendliches Scrollen
Paginierung teilt Inhalte in nummerierte Seiten mit eigener URL. Load-More lädt weitere Elemente per Klick auf derselben Seite nach, Infinite Scroll tut dasselbe automatisch beim Scrollen. Die drei Muster lösen dasselbe Problem auf unterschiedliche Weise, und die Wahl hängt stark vom Content-Typ ab.
Bei großen Produktkatalogen oder Archivseiten liefert klassische Paginierung einen entscheidenden Vorteil: Die Position im Katalog ist über die URL eindeutig adressierbar, verlinkbar und merkbar. Für redaktionelle Feeds oder Social-Media-artige Inhalte wirkt Infinite Scroll dagegen natürlicher, weil Nutzer selten gezielt zu „Seite 7“ zurückkehren wollen.
Performance spielt ebenfalls eine Rolle. Infinite Scroll lädt oft mehr DOM-Elemente gleichzeitig, was auf schwächeren Geräten zu Rucklern führen kann. Paginierte Seiten bleiben schlank, weil jede Ansicht nur einen Bruchteil der Gesamtdaten rendert.
Eine kurze Entscheidungshilfe für technische Teams:
- Große Produktkataloge oder Verzeichnisse: klassische Paginierung bevorzugen.
- Redaktionelle Feeds mit geringem Rücksprungbedarf: Load-More oder Infinite Scroll erwägen.
- Mobile-lastige Angebote mit begrenzter Rechenleistung: paginierte Varianten schonen Ladezeit und Speicher.
- SEO-kritische Kategorieseiten: Paginierung, weil sich jede Seite einzeln ranken lässt.
Die Entscheidung ist selten rein technisch. Sie hängt davon ab, ob einzelne Teilseiten eigenständigen Suchwert haben oder ob nur die Gesamtmenge zählt.
Wie Google und andere Suchsysteme paginierte Inhalte finden und verarbeiten
Suchmaschinen-Crawler folgen Links, die als echtes href-Attribut im HTML stehen. Ein Button, der nur per JavaScript-Klick-Handler weiterblättert, ohne dass ein klickbarer Link dahintersteckt, bleibt für viele Crawler unsichtbar und damit unentdeckt. Google Search Central empfiehlt deshalb, jede Folgeseite über einen regulären Link mit eigener URL erreichbar zu machen und Fragment-IDs wie #page2 zu vermeiden, da diese von Crawlern ignoriert werden und zu Duplicate-Content-Risiken führen.
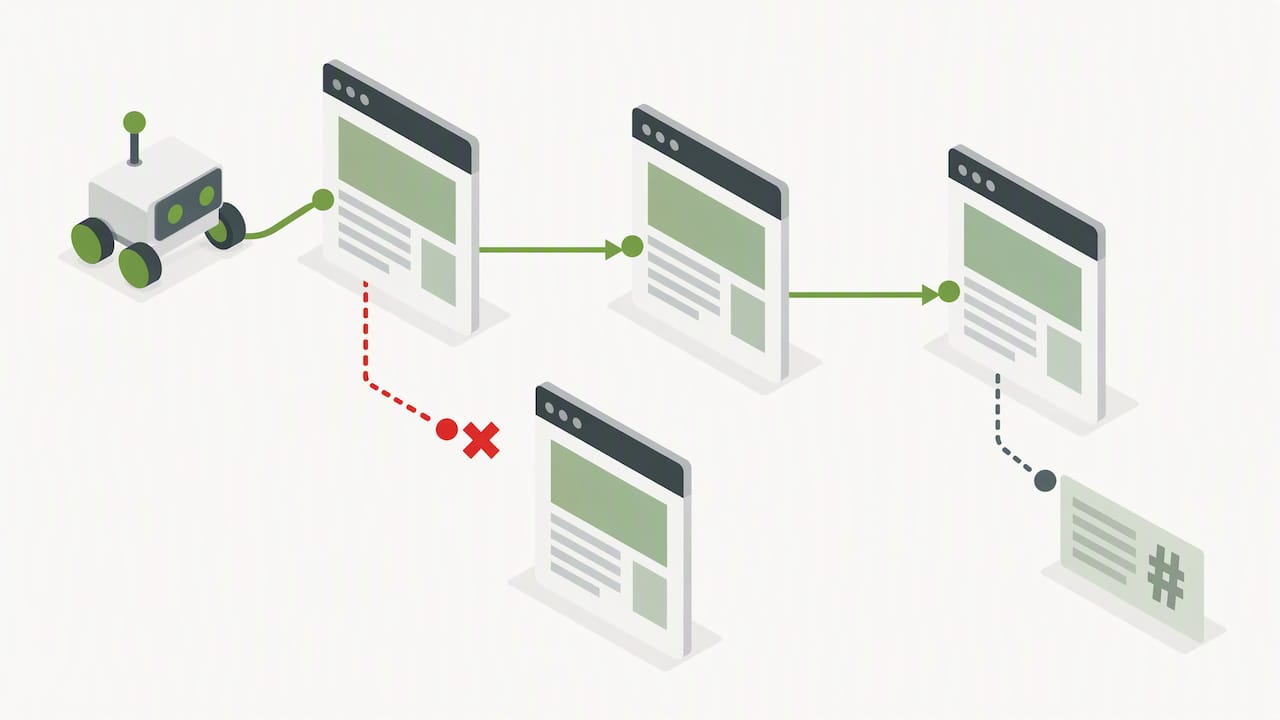
Rel=next/prev wird von Google seit Jahren nicht mehr für die Indexierung ausgewertet, wie Search Engine Land bereits 2019 berichtete. Das Markup kann dennoch für Barrierefreiheit und bestimmte Browserfunktionen sinnvoll bleiben, ersetzt aber keine saubere URL-Struktur.
Bing verfolgt einen ähnlichen, aber eigenständigen Ansatz. Die Bing Webmaster Guidelines betonen Crawl-Effizienz: XML-Sitemaps, konsistente Canonicals und die Nutzung von IndexNow helfen, Crawl-Budget nicht an irrelevante URL-Varianten zu verschwenden. Gerade bei großen Shops mit vielen Filterkombinationen ist das entscheidend, denn jede unnötig gecrawlte Parameterkombination verdrängt potenziell wichtigere Seiten aus dem Crawl-Zyklus.
Konkrete SEO-Best-Practices für paginierte Seiten
Für die technische Umsetzung gibt es eine überschaubare Anzahl an Regeln, die sich in der Praxis immer wieder bewähren:
- Verwende ein konsistentes URL-Schema wie
?page=2, niemals Fragment-IDs nach einem Rautezeichen. - Setze auf jeder paginierten Seite einen Self-Canonical, der auf die eigene URL zeigt, nicht auf Seite eins.
- Behandle Filter- und Sortier-Varianten gezielt: Entweder per Canonical auf die Basisseite verweisen, wenn es sich um echte Subsets handelt, oder eine eigenständige Serie mit eigenen Canonicals aufbauen, wenn die Filteransicht eigenständig ranken soll, wie es Search Engine Land für komplexe Facettennavigation beschreibt.
- Reiche alle paginierten URLs über die Sitemap ein und nutze IndexNow, um Bing schneller über neue Seiten zu informieren.
- Setze Prefetch und Preconnect ausschließlich zur Beschleunigung des Nachladens, nicht als Ersatz für echte Links.
- Formuliere Title und Meta-Description für Serienseiten eindeutig, etwa mit einem Hinweis auf die Seitenzahl, damit Suchende die richtige Teilseite erkennen.
Ein häufiger Fehler entsteht, wenn Entwickler aus Vorsicht vor Duplicate Content sämtliche Folgeseiten auf Seite eins kanonisieren. Das Ergebnis: Google sieht nur noch die erste Seite als relevant und ignoriert den Rest der Serie, selbst wenn dort einzigartige Produkte oder Artikel liegen.
Profi-Tipp:Prüfe bei jeder neuen Kategorieseite zuerst, ob Folgeseiten eigenständigen Inhalt tragen, bevor du eine Canonical-Strategie festlegst.
Für Redirects bei URL-Umzügen innerhalb einer paginierten Struktur lohnt sich ein Blick auf unsere Anleitung zu 301- und 302-Weiterleitungen, und wer Title-Tags für Serienseiten optimieren will, findet ergänzende Hinweise in unserer Checkliste für bessere Auffindbarkeit.
Alternativen zur Pagination und wie man sie SEO-sicher macht
View-All-Seiten fassen eine ganze Serie auf einer URL zusammen und eignen sich gut für überschaubare Mengen, stoßen aber bei mehreren tausend Einträgen an Ladezeit-Grenzen. Load-More-Buttons sollten immer einen echten href-Fallback besitzen, damit Crawler auch ohne JavaScript-Ausführung weiterkommen, und die History API nutzen, um die URL beim Nachladen sichtbar zu aktualisieren.
Infinite Scroll braucht entweder serverseitiges Rendering oder eine Kombination aus History API und Anker-URLs, damit jede nachgeladene Sektion eine eigene, klickbare Adresse bekommt. Ohne diese Technik bleiben nachgeladene Inhalte für Suchmaschinen häufig unsichtbar, wie die MDN-Dokumentation zur History API für die technische Umsetzung beschreibt.
- View-All eignet sich für kleinere, überschaubare Listen mit begrenzter Elementzahl.
- Load-More braucht einen klickbaren Link mit echtem
href, nicht nur einen JavaScript-Handler. - Infinite Scroll erfordert Anker-URLs und History-API-Updates, sonst verschwinden Folgeinhalte aus dem Index.
Die Entscheidung zwischen UX-Komfort und SEO-Sichtbarkeit lässt sich fast immer technisch lösen, wenn man sie früh mitdenkt statt nachträglich zu patchen.
Umsetzungs-Checkliste und Tests: Von URL-Schema bis Logfile-Analyse
Vor dem Launch einer paginierten Struktur lohnt sich eine systematische Prüfung, statt sich auf Annahmen zu verlassen.
- Prüfe das URL-Schema auf Konsistenz und stelle sicher, dass keine Fragment-IDs im Spiel sind.
- Kontrolliere, dass jede Seite ihren eigenen Canonical-Tag trägt und nicht versehentlich auf Seite eins zeigt.
- Stelle sicher, dass robots.txt keine wichtigen Parameter blockiert und die Sitemap alle relevanten Seiten enthält.
- Teste einzelne URLs über die Live-URL-Prüfung in der Google Search Console, um Rendering und Indexierbarkeit zu verifizieren.
- Führe eine Logfile-Analyse durch, um zu sehen, ob Googlebot und Bingbot tatsächlich alle Seiten der Serie besuchen.
- Beobachte Index-Status, Crawl-Rate, Impressionen und Ranking-Trends über mehrere Wochen, um Verschiebungen früh zu erkennen.
Typische Fehlerbilder zeigen sich meist in denselben Mustern: Folgeseiten, die trotz Sitemap-Eintrag nicht gecrawlt werden, Canonical-Ketten, die versehentlich auf die falsche Seite zeigen, oder robots.txt-Regeln, die ganze Parameterbereiche sperren und damit Crawl-Budget verschwenden, wie es auch in unserer Übersicht zu typischen SEO-Fehlern beschrieben wird. Komplexe JavaScript-Lösungen verschärfen diese Probleme häufig zusätzlich, da einfache HTML-Links robuster funktionieren als nachgebaute Navigationslogik.
Profi-Tipp:Vergleiche Crawl-Logs vor und nach jeder Pagination-Änderung, bevor du eine größere Struktur-Umstellung als abgeschlossen betrachtest.
Kurze Agenturperspektive: Nutzerorientierung vor fragilen Hacks
Aus unserer Projekterfahrung zeigt sich immer wieder: Stabile Nutzerführung und saubere Technik schlagen kleine Rankingtricks auf Dauer. Wer versucht, Crawler mit künstlichen Canonical-Konstruktionen auszutricksen, riskiert Indexverlust, sobald sich Google-Algorithmen weiterentwickeln. Eine robuste URL-Struktur bleibt dagegen stabil, unabhängig von Markup-Moden wie rel=next/prev, die kommen und wieder verschwinden. Bei komplexen Relaunches oder plötzlichen Rankingverlusten im Zusammenhang mit paginierten Strukturen lohnt sich ein technisches Audit, bevor Symptome zu dauerhaften Sichtbarkeitsverlusten werden.
Angebot: Technisches Audit und Workshops für saubere Pagination
Wenn paginierte Kategorien oder Filterlogiken in der Praxis zu Indexierungsproblemen führen, lohnt sich eine gezielte technische Prüfung statt wiederholter Einzelkorrekturen. Unser Technisches Audit deckt URL-Struktur, Canonical-Logik und Crawl-Verhalten konkret auf, und bei bevorstehenden Relaunches sichert unsere Relaunch-Absicherung die Sichtbarkeit paginierter Bereiche während der Migration ab.
Für Teams, die selbst tiefer in technische SEO-Entscheidungen einsteigen wollen, bieten unsere Workshops einen praxisnahen Einstieg, etwa zu technischem SEO oder zur Planung eines SEO-sicheren Relaunches. Wer unsicher ist, wo das eigene Pagination-Setup steht, kann die passenden Leistungen und Preise direkt auf unserer Übersichtsseite zu SEO-Leistungen prüfen und ein Erstgespräch anfragen.
FAQ
Was bedeutet Pagination im Kontext von SEO?
Pagination bezeichnet die Aufteilung langer Inhalte oder Listen auf mehrere Seiten mit jeweils eigener URL. Im SEO-Kontext geht es vor allem darum, diese Seiten so zu strukturieren, dass Suchmaschinen sie einzeln finden, crawlen und ohne Duplicate-Content-Konflikte indexieren können.
Was bedeutet der Begriff Paginierung genau?
Paginierung ist die technische Umsetzung, bei der ein großer Datenbestand, etwa ein Produktkatalog oder ein Artikel-Archiv, in nummerierte Teilseiten gegliedert wird. Jede Teilseite erhält dabei typischerweise eine eigene URL mit einem Seitenparameter wie ?page=2.
Worin unterscheidet sich Pagination von Lazy Loading?
Pagination teilt Inhalte in separate, eigenständig adressierbare Seiten auf, während Lazy Loading einzelne Elemente wie Bilder erst beim Erreichen des sichtbaren Bereichs nachlädt, meist innerhalb derselben Seite. Lazy Loading betrifft also primär die Ladereihenfolge von Ressourcen, nicht die URL-Struktur des Inhalts selbst.
Welche Arten von Pagination gibt es?
Gängige Varianten sind die klassische nummerierte Paginierung mit Seitenzahlen, Load-More-Buttons, die weitere Elemente auf Klick nachladen, und Infinite Scroll, das automatisch beim Scrollen neue Inhalte lädt. Jede Variante erfordert eine eigene technische Herangehensweise, damit Suchmaschinen den vollständigen Inhalt erfassen können.
Ist rel=next/prev für die Google-Indexierung noch relevant?
Nein, Google nutzt rel=next/prev laut Search Engine Land schon seit Jahren nicht mehr für Indexierungsentscheidungen. Eine saubere URL-Struktur mit Self-Canonical ersetzt dieses Markup vollständig.
Empfehlungen