JavaScript-SEO: Rendering und Indexierung
JavaScript-SEO sorgt dafür, dass Inhalte, Links und Metadaten einer JavaScript-gestützten Website für Suchmaschinen erreichbar sind, obwohl sie erst im Browser entstehen. Google kann JavaScript ausführen. Ob eine Seite aber vollständig, korrekt und rechtzeitig indexiert wird, hängt von drei Faktoren ab: wie die Seite gerendert wird, welche Signale schon im ersten HTML stehen und ob Fehler wie Soft-404s oder blockierte Ressourcen im Code stecken. Dieser Leitfaden erklärt die Verarbeitung durch Google, vergleicht die Rendering-Strategien, nennt die häufigsten Fehlerquellen und zeigt, wie Sie nach einem Relaunch oder einem plötzlichen Rankingverlust prüfen, ob JavaScript die Ursache ist.
JavaScript-Seiten für Google sichtbar machen
SEYBOLD ONE verbindet technisches SEO mit datengetriebenen Strategien, um Rendering-Probleme und mögliche Ursachen für Rankingverluste gezielt zu prüfen.
Unverbindliche Beratung anfragenWas JavaScript-SEO umfasst
Google selbst beschreibt JavaScript-SEO als Optimierung JavaScript-fähiger Webanwendungen für die Google Suche und widmet dem Thema eine eigene Dokumentation, die Grundlagen von JavaScript-SEO. Die Disziplin ist ein Teilbereich des technischen SEO. Sie betrifft vor allem Websites, die auf Frameworks wie React, Vue oder Angular basieren, Single-Page-Applications, Shops mit clientseitig nachgeladenen Produktlisten und alle Seiten, deren Hauptinhalt, interne Verlinkung oder Meta-Angaben per JavaScript erzeugt oder verändert werden.
Im Kern geht es um eine Frage: Stimmt das, was Googlebot nach dem Rendering sieht, mit dem überein, was ein Nutzer im Browser sieht? Wenn Überschriften, Produkttexte, Canonical-Tags oder Links erst nach einer Interaktion, einem API-Aufruf oder einem Cookie-Check erscheinen, entsteht eine Lücke zwischen Nutzer- und Crawler-Sicht. Genau diese Lücke ist die Ursache der meisten JavaScript-SEO-Probleme. Eine kompakte Begriffserklärung finden Sie auch in unserem Glossar zu JavaScript-SEO.
Wie Google JavaScript-Seiten verarbeitet
Google verarbeitet JavaScript-Seiten laut Search Central in drei Phasen: Crawling, Rendering und Indexierung. Wer diese Abfolge versteht, erkennt schnell, an welcher Stelle eine Seite hängen bleibt.
- Crawling: Googlebot prüft zuerst die robots.txt, ruft die erlaubte URL ab und extrahiert weitere URLs aus den
href-Attributen von HTML-Links. Links, die nur überonclick-Handler oder JavaScript-Routing ohne echtes<a href>funktionieren, werden in dieser Phase nicht zuverlässig entdeckt. - Rendering: Seiten mit HTTP-Statuscode 200 werden in eine Warteschlange für das Rendering gestellt. Der Web Rendering Service (WRS) führt das JavaScript mit einem aktuellen Chromium aus und erzeugt das gerenderte HTML. Seiten mit Fehlerstatus oder einem Noindex-Signal im Ausgangs-HTML werden in der Regel gar nicht erst gerendert.
- Indexierung: Google verwendet das gerenderte HTML zur Indexierung und extrahiert daraus auch die Links, die erst durch JavaScript entstanden sind. Diese gehen anschließend wieder ins Crawling ein.
Die oft beschworene „zweite Welle“ der Indexierung, bei der Wochen zwischen Crawling und Rendering liegen sollen, ist in dieser Form überholt. Eine Auswertung von Vercel zur JavaScript-Verarbeitung durch Google mit über 100.000 Googlebot-Abrufen ergab, dass alle indexierbaren HTML-Seiten mit Statuscode 200 vollständig gerendert wurden und der Median der Rendering-Verzögerung bei rund zehn Sekunden lag. Einzelne Seiten warteten allerdings deutlich länger. Für Websites mit Hunderttausenden URLs, häufig wechselnden Inhalten oder knappem Crawl-Budget bleibt diese Verzögerung relevant, weil neue oder geänderte Inhalte später im Index ankommen.
Besonders kritisch ist der Umgang mit Meta-Robots-Angaben. Google stellt in seiner Dokumentation klar, dass es bei einem noindex im ursprünglichen HTML das Rendering und die JavaScript-Ausführung überspringen kann. Ein Skript, das ein noindex nachträglich entfernen soll, greift dann nicht. Indexierungsrelevante Signale wie Robots-Angaben, Canonical und Statuscode gehören deshalb ins serverseitig ausgelieferte HTML oder in den HTTP-Header, etwa per X-Robots-Tag.
Im SEO-Leitfaden für Webentwickler fasst Google die Lage nüchtern zusammen: JavaScript kann grundsätzlich ausgeführt werden, beim Design müssen aber Besonderheiten und Einschränkungen für Crawling und Rendering berücksichtigt werden. Hinzu kommt, dass Google nicht der einzige Abnehmer Ihrer Inhalte ist. Ob andere Crawler, etwa die von KI-Antwortsystemen, JavaScript ausführen, ist nicht garantiert. Serverseitig ausgeliefertes HTML ist daher die robustere Grundlage für Sichtbarkeit in klassischer Suche und in KI-Antworten.
Rendering-Strategien im Vergleich
Die Wahl der Rendering-Strategie entscheidet darüber, wie viel Arbeit beim Crawler liegt und wie früh der eigentliche Inhalt im HTML steht. Nach den Erläuterungen von web.dev zu JavaScript und der Google-Suche beeinflusst die Rendering-Strategie sowohl Leistung als auch Robustheit; Server-Rendering und Pre-Rendering stellen den ersten HTML-Inhalt früher bereit.
| Strategie | Wo der Inhalt entsteht | Vorteile für SEO | Risiken | Geeignet für |
|---|---|---|---|---|
| Clientseitiges Rendering (CSR) | Im Browser, durch JavaScript | Geringe Serverlast, app-artige Bedienung | Inhalt fehlt im Ausgangs-HTML, abhängig von Rendering, Ressourcen und APIs | Eingeloggte Bereiche, Dashboards, Tools ohne Suchrelevanz |
| Serverseitiges Rendering (SSR) | Auf dem Server, pro Anfrage | Vollständiges HTML sofort verfügbar, Signale eindeutig | Höhere Serverlast, komplexere Infrastruktur | Shops, Kategorieseiten, redaktionelle Inhalte |
| Statisches Pre-Rendering (SSG) | Beim Build, als fertige HTML-Dateien | Sehr schnell, stabil, leicht cachebar | Aktualisierung erfordert neuen Build | Ratgeber, Landingpages, Dokumentationen |
| Hybrid mit Hydration | Server liefert HTML, Browser übernimmt danach | Vereint indexierbares HTML und Interaktivität | Abweichungen zwischen Server- und Client-Ausgabe | Die meisten modernen Framework-Projekte |
| Dynamisches Rendering | Server erkennt Crawler und liefert ihnen vorgerenderte Version | Kurzfristige Entlastung bei Altsystemen | Zwei Versionen pflegen, Fehleranfälligkeit, laut Google nur Behelfslösung | Übergangsphase bis zur Umstellung |
Clientseitiges Rendering
Beim clientseitigen Rendering lädt der Browser ein weitgehend leeres HTML-Gerüst und ein JavaScript-Bundle, das den Inhalt während der Ausführung erzeugt. Für Nutzer ist das oft unproblematisch, für Suchmaschinen bedeutet es: Der Inhalt existiert erst nach dem Rendering. Jeder Fehler in dieser Kette, ein blockiertes Skript, eine langsame API, ein Timeout oder ein Fehler im Code, führt dazu, dass Google eine leere oder unvollständige Seite indexiert. CSR ist nicht per se schlecht für SEO, aber es verschiebt das Risiko vollständig auf den Rendering-Schritt.
Serverseitiges Rendering und Pre-Rendering
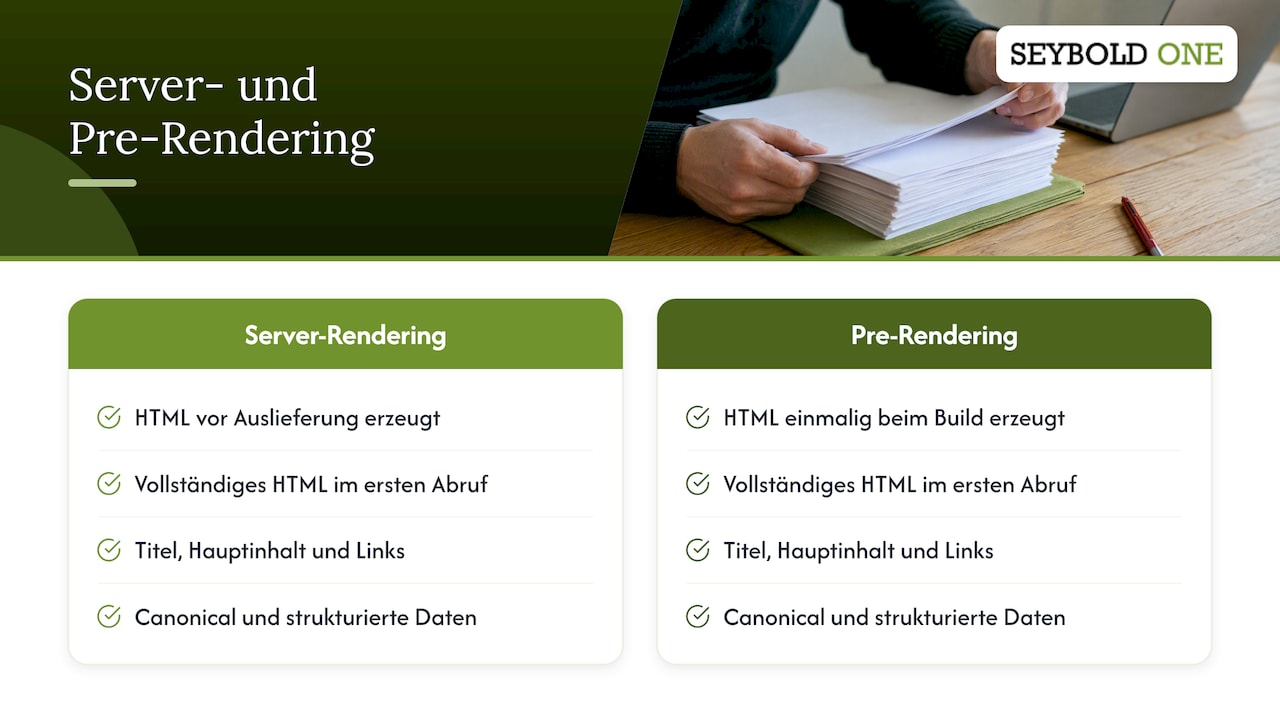
Beim serverseitigen Rendering erzeugt der Server das vollständige HTML, bevor es ausgeliefert wird. Titel, Hauptinhalt, interne Links, Canonical und strukturierte Daten stehen damit bereits im ersten Abruf. Statisches Pre-Rendering verfolgt dasselbe Ziel, erzeugt das HTML aber einmalig beim Build. Moderne Frameworks bieten beide Varianten an und erlauben, sie pro Seitentyp zu kombinieren: Ratgeberseiten statisch, Produktseiten mit Server-Rendering, der Warenkorb clientseitig. Für suchrelevante Seiten empfehlen wir diesen Weg als Standard.
Dynamisches Rendering: eine Behelfslösung
Beim dynamischen Rendering erkennt der Server Crawler anhand des User-Agents und liefert ihnen eine servergerenderte Version, während Nutzer die clientseitige Version erhalten. Google bezeichnet dynamisches Rendering ausdrücklich als Behelfslösung und nicht als langfristige Lösung, weil es zusätzliche Komplexität und Ressourcenanforderungen verursacht. In der Praxis sehen wir bei solchen Setups regelmäßig, dass die Crawler-Version veraltet, unvollständig oder nach einem Deployment fehlerhaft ist, ohne dass es jemand bemerkt, weil die Nutzer die korrekte Version sehen. Wer dynamisches Rendering noch einsetzt, sollte die Umstellung auf SSR oder Pre-Rendering einplanen.
Typische JavaScript-SEO-Probleme
Google listet in der Anleitung zur Behebung suchbezogener JavaScript-Probleme eine Reihe wiederkehrender Fehlerbilder auf. Die folgende Übersicht ordnet sie nach Symptom und Lösung.
| Problem | Typisches Symptom | Lösung |
|---|---|---|
| Soft-404 in Single-Page-Apps | Fehlerseiten liefern HTTP 200 und landen im Index | Echten 404-Status serverseitig senden oder per JavaScript auf eine 404-URL weiterleiten bzw. noindex setzen |
URL-Fragmente (#/produkt) | Unterseiten werden nicht als eigene URLs erkannt | History API mit sauberen Pfaden verwenden |
| Abhängigkeit von gespeichertem Zustand | Inhalte erscheinen nur mit Cookie, LocalStorage oder Login | Inhalte zustandslos ausliefern, da der WRS Zustände zwischen Abrufen nicht behält |
| Nicht unterstützte APIs oder Berechtigungen | Inhalt bleibt leer, weil etwa Standortfreigabe erwartet wird | Feature Detection mit Fallback einsetzen |
| Veraltete JS- und CSS-Ressourcen im Cache | Gerenderte Seite bricht nach einem Deployment | Content-Fingerprinting in Dateinamen, etwa main.2bb85551.js |
| Webkomponenten ohne sichtbaren Inhalt | Shadow-DOM-Inhalt fehlt im gerenderten HTML | Inhalte über Slots in das Light DOM bringen und gerendertes HTML prüfen |
Links ohne href | Unterseiten werden nicht entdeckt | Echte <a href>-Links verwenden |
| Nachladen erst bei Scroll oder Klick | Produkte oder Absätze fehlen im Index | Inhalte ohne Interaktion laden, Pagination mit eigenen URLs anbieten |
Zwei Punkte verdienen besondere Aufmerksamkeit. Erstens Soft-404s: Weil die clientseitige Fehlerbehandlung einer Single-Page-App oft einen Statuscode 200 zurückgibt, kann Google Hunderte leerer Fehlerseiten indexieren und damit Crawl-Budget sowie die Qualitätsbewertung der Domain belasten. Zweitens nachgeladene Inhalte: Googlebot scrollt nicht wie ein Mensch und klickt keine „Mehr laden“-Schaltflächen. Wie Sie Inhalte so nachladen, dass sie trotzdem erfasst werden, beschreiben wir im Beitrag zu nachladenden Inhalten für Googlebot. Für Kategorieseiten und Listen gilt zusätzlich, dass jede Seite eine eigene, verlinkte URL braucht, wie im Ratgeber zur Pagination im SEO erläutert.
Ein weiteres, häufig übersehenes Problem ist die Blockade von Ressourcen. Werden JavaScript-Dateien, CSS oder API-Endpunkte per robots.txt gesperrt, kann der WRS die Seite nicht vollständig aufbauen. Das Ergebnis ist eine gerenderte Seite, die für Google anders aussieht als für Nutzer, ohne dass im Quellcode ein Fehler erkennbar wäre.
So prüfen Sie, was Google tatsächlich sieht
Der wichtigste Grundsatz lautet: prüfen statt annehmen. Der Quelltext im Browser zeigt das Ausgangs-HTML, das Entwickler-Tool zeigt das DOM in Ihrem Browser, aber keines von beiden zeigt zwingend, was Google gerendert hat. Gehen Sie in dieser Reihenfolge vor:
- URL-Prüftool der Search Console: Rufen Sie für eine repräsentative URL je Seitentyp den Live-Test auf und öffnen Sie das gerenderte HTML. Prüfen Sie, ob Hauptinhalt, Überschriften, interne Links, Canonical und strukturierte Daten vorhanden sind.
- Geladene Ressourcen und JavaScript-Konsole: Im selben Test zeigt Google, welche Ressourcen nicht geladen werden konnten und welche JavaScript-Ausnahmen auftraten. Blockierte oder fehlerhafte Skripte sind hier sofort sichtbar.
- Test für Rich-Suchergebnisse: Das Tool rendert ebenfalls mit dem WRS und eignet sich, wenn Sie keinen Search-Console-Zugang zur Domain haben.
- Vergleich Ausgangs-HTML und gerendertes HTML: Ein Crawler mit und ohne JavaScript-Rendering zeigt, welche Inhalte und Links ausschließlich durch JavaScript entstehen. Je größer diese Differenz, desto höher das Risiko.
- Bericht „Crawling-Statistiken“: Er zeigt die Aktivität von Googlebot und WRS. Google weist darauf hin, dass clientseitige Analysetools diese Aktivität möglicherweise nicht vollständig oder genau abbilden; Logfiles des Servers liefern das genauere Bild.
- Seitenindexierungsbericht: Häufungen bei „Soft 404“, „Gecrawlt – zurzeit nicht indexiert“ oder „Duplikat, Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt“ deuten oft auf Rendering- oder Signalprobleme hin. Hintergründe dazu finden Sie im Glossar zur Indexierung.
Diagnose nach Relaunch oder Rankingverlust
Viele JavaScript-SEO-Probleme werden nicht beim Aufbau einer Website sichtbar, sondern beim Relaunch: Ein neues Frontend-Framework, ein Headless-CMS oder ein Theme-Wechsel verlagert Inhalte, die bisher im HTML standen, plötzlich in clientseitige Komponenten. Die Rankings fallen dann nicht sofort, sondern schrittweise, sobald Google die neuen Versionen gerendert und neu bewertet hat. Für die Diagnose hat sich folgendes Vorgehen bewährt:
- Zeitpunkt eingrenzen: Gleichen Sie den Beginn des Rückgangs in der Search Console mit Deployments, Relaunch-Terminen und Google-Updates ab. Ein Abfall, der exakt mit einem Release beginnt, spricht für eine technische Ursache.
- Betroffene Seitentypen identifizieren: Verlieren nur Kategorieseiten, nur Produktseiten oder nur bestimmte Verzeichnisse? Ein Muster nach Seitentyp verweist fast immer auf ein Template oder eine Komponente.
- Alt und neu vergleichen: Stellen Sie das Ausgangs-HTML und das gerenderte HTML der alten Version (aus Archiven oder Crawls vor dem Relaunch) der neuen Version gegenüber: Textmenge, Überschriften, interne Links, Canonical, Meta-Robots, strukturierte Daten.
- Signale im Ausgangs-HTML prüfen: Steht ein
noindexaus der Staging-Umgebung noch im Template? Zeigt das Canonical auf eine falsche Domain? Wird der Statuscode für nicht existierende URLs korrekt gesetzt? - Interne Verlinkung nachzählen: Wenn Navigation, Filter oder Breadcrumbs nach dem Relaunch ohne echtes
hrefarbeiten, verlieren tiefere Seiten ihre interne Verlinkung. Das erklärt häufig, warum Unterseiten nach und nach aus dem Index fallen. - Logfiles auswerten: Server-Logs zeigen, welche URLs und Ressourcen Googlebot tatsächlich abruft, ob API-Endpunkte erreichbar sind und ob die Crawl-Frequenz nach dem Relaunch eingebrochen ist.
- Korrigieren, priorisieren, validieren: Beheben Sie zuerst Fehler mit großer Reichweite, also Templates und globale Komponenten, testen Sie die Korrektur im URL-Prüftool und beantragen Sie die Indexierung für zentrale URLs. Die Erholung zieht sich je nach Umfang über Wochen, weil Google die betroffenen Seiten erneut crawlen und rendern muss.
Wer diese Schritte vor dem Livegang auf einer Staging-Umgebung durchläuft, verhindert die meisten Verluste von vornherein. Eine strukturierte Übersicht der Basisprüfungen bietet unsere Checkliste zu SEO-Grundlagen.
Best Practices für Entwicklung und SEO
Aus Googles Empfehlungen und unserer Projekterfahrung ergeben sich Regeln, die Entwicklungs- und SEO-Team gemeinsam festhalten sollten, idealerweise als Abnahmekriterien in jedem Release:
- Suchrelevante Inhalte serverseitig ausliefern: Hauptinhalt, Titel, Meta-Description, Canonical und strukturierte Daten stehen im ersten HTML-Abruf.
- Aussagekräftige HTTP-Statuscodes senden: 404 für nicht existierende Seiten, 301 für dauerhafte Weiterleitungen, niemals eine Fehlerseite mit 200.
- History API statt Fragmenten: Jede indexierbare Ansicht hat eine eigene, sprechende URL.
- Echte Links verwenden: Navigation, Pagination und Filter, die indexiert werden sollen, arbeiten mit
<a href>. - Keine Abhängigkeit von Zustand oder Berechtigungen: Inhalte laden ohne Cookie-Zustimmung, Login, LocalStorage oder Standortfreigabe.
- Feature Detection mit Fallback: Wenn eine Browser-API fehlt, wird der Inhalt trotzdem ausgegeben.
- Content-Fingerprinting für Ressourcen: Versionierte Dateinamen verhindern, dass der WRS nach einem Deployment veraltete Skripte nutzt.
- Ressourcen nicht blockieren: JavaScript, CSS und benötigte API-Endpunkte bleiben für Googlebot erreichbar.
- Gerendertes HTML regelmäßig testen: Nach jedem größeren Release je Seitentyp mindestens eine URL im URL-Prüftool kontrollieren.
Unsere Sicht auf JavaScript-SEO
In über 25 Jahren Sichtbarkeitsmanagement haben wir gelernt, dass JavaScript selten das eigentliche Problem ist. Das Problem ist die Annahme, dass Google schon sehen wird, was der Nutzer sieht. Bei Rankingverlusten nach einem Relaunch finden wir in forensischen Analysen immer wieder dieselben Muster: Inhalte, die nur noch clientseitig entstehen, interne Links ohne href, Staging-Signale im Template oder Fehlerseiten mit Statuscode 200. Keines dieser Muster ist im Browser sichtbar, und deshalb bleiben sie oft monatelang unentdeckt.
Unser Ansatz ist datengetrieben: Wir vergleichen Ausgangs-HTML, gerendertes HTML und Logfiles, statt uns auf einzelne Tool-Warnungen zu verlassen. Und wir empfehlen Unternehmen, Rendering nicht als Entscheidung der Entwicklung allein zu behandeln, sondern als Sichtbarkeitsentscheidung. Wer heute eine Architektur wählt, entscheidet damit nicht nur über die Indexierung bei Google, sondern auch darüber, ob Antwortsysteme der KI-Suche die Inhalte überhaupt lesen können. Serverseitig ausgeliefertes, sauber strukturiertes HTML ist für uns deshalb kein technisches Detail, sondern die Grundlage jeder nachhaltigen Sichtbarkeit.
Unterstützung bei JavaScript-SEO
Wenn Sie nach einem Relaunch oder einem Framework-Wechsel Sichtbarkeit verloren haben oder einen Umbau absichern möchten, bieten wir dafür passende Leistungen an. Ein Technisches Audit kostet 1.500 bis 3.500 €, ein Forensisches Audit zur Ursachenanalyse plötzlicher Rankingverluste 1.500 bis 5.500 €, die Relaunch-Absicherung beginnt ab 1.500 €. Wer das Wissen ins eigene Team holen möchte, findet im Technical SEO Workshop ab 500 € den Einstieg. Alle Pakete und Preise finden Sie in unserer Übersicht Was kostet SEO? Als ersten Schritt können Sie eine kostenlose Erstanalyse beauftragen.
Häufige Fragen zu JavaScript-SEO
Kann Google JavaScript überhaupt lesen?
Ja. Google rendert Seiten mit einem aktuellen Chromium und indexiert das gerenderte HTML. Das gilt jedoch nur, wenn das Rendering fehlerfrei gelingt, alle benötigten Ressourcen erreichbar sind und im Ausgangs-HTML kein noindex steht. Ob andere Suchmaschinen und KI-Crawler JavaScript ebenso ausführen, ist nicht sichergestellt.
Ist serverseitiges Rendering für SEO immer besser?
Für suchrelevante Seiten ist serverseitiges Rendering oder statisches Pre-Rendering die robusteste Wahl, weil Inhalt und Signale sofort im HTML stehen. Für eingeloggte Bereiche, Konfiguratoren oder Dashboards ohne Suchrelevanz ist clientseitiges Rendering unproblematisch. Die meisten Projekte fahren mit einer hybriden Lösung pro Seitentyp am besten.
Sollte ich noch dynamisches Rendering einsetzen?
Google bezeichnet dynamisches Rendering als Behelfslösung und nicht als langfristige Lösung. Für Altsysteme kann es eine Übergangsphase überbrücken, es erfordert aber die Pflege zweier Versionen und ist fehleranfällig. Planen Sie die Umstellung auf SSR oder Pre-Rendering ein.
Woran erkenne ich, dass JavaScript meine Rankings kostet?
Typische Hinweise sind ein Rückgang, der zeitlich mit einem Release zusammenfällt, steigende Zahlen bei „Soft 404“ oder „Gecrawlt – zurzeit nicht indexiert“ sowie fehlende Inhalte oder Links im gerenderten HTML des URL-Prüftools. Den Beweis liefert der Vergleich von Ausgangs-HTML, gerendertem HTML und Server-Logfiles.
Quellen
- Grundlagen von JavaScript-SEO, Google Search Central
- SEO-Leitfaden für Webentwickler, Google Search Central
- Suchbezogene JavaScript-Probleme beheben, Google Search Central
- Dynamisches Rendering als Behelfslösung, Google Search Central
- JavaScript und die Google-Suche aufeinander abstimmen, web.dev
- Wie Google JavaScript im gesamten Indexierungsprozess verarbeitet, Vercel (englisch)
Empfehlungen