Robots Meta Tags: Direktiven richtig setzen und Fehler vermeiden
Ein Robots-Meta-Tag teilt Suchmaschinen mit, ob und wie eine Seite indexiert, verlinkt und in der Vorschau dargestellt werden darf. Für HTML-Seiten steht die Anweisung als Meta-Tag im <head>, für PDFs, Bilder und andere Nicht-HTML-Ressourcen übernimmt der X-Robots-Tag-HTTP-Header diese Aufgabe. Wichtig vorab: Robots-Direktiven sind kein Zugangsschutz, denn sie regeln nur das Verhalten kooperativer Crawler.
Sichtbarkeit strategisch verbessern
SEYBOLD entwickelt datengetriebene SEO-Strategien für bessere Suchmaschinen- und KI-Sichtbarkeit, auch bei Rankingverlusten oder Google-Abstrafungen.
Unverbindliche Beratung anfragenSyntax und gültige Direktiven des Robots-Meta-Tags
Die Grundsyntax lautet <meta name="robots" content="noindex,follow">. Wer nur den Googlebot ansprechen möchte, ersetzt robots durch googlebot. Mehrere Crawler lassen sich über zusätzliche Meta-Tags getrennt steuern.
Laut der Spezifikation von Google Search Central stehen folgende Direktiven zur Verfügung:
- all: keine Einschränkung, entspricht dem Standardverhalten.
- index / noindex: Die Seite darf beziehungsweise darf nicht in den Suchergebnissen erscheinen.
- follow / nofollow: Links auf der Seite dürfen beziehungsweise dürfen nicht weiterverfolgt werden.
- none: entspricht der Kombination
noindex,nofollow. - nosnippet: kein Textausschnitt und kein Video-Snippet in der Vorschau.
- max-snippet:<Zahl>: begrenzt die Snippet-Länge auf die angegebene Zeichenzahl.
- max-image-preview:<Einstellung>: steuert die maximale Bildvorschaugröße (
none,standard,large). - max-video-preview:<Zahl>: begrenzt die Vorschaudauer eines Videos in Sekunden.
- indexifembedded: erlaubt die Indexierung eingebetteter Inhalte, auch wenn die eigene URL
noindexträgt.
Wichtig: Fehlt der Meta-Tag komplett, gilt automatisch index,follow. Laut Googles Dokumentation entspricht none für Google exakt noindex,nofollow und hat keine zusätzliche Wirkung.
X-Robots-Tag HTTP-Header: Wann und wie ihn einsetzen
Für Dateien ohne HTML-Head, etwa PDFs, Word-Dokumente oder Bilder, lässt sich die Robots-Anweisung nicht als Meta-Tag unterbringen. Hier greift der X-Robots-Tag als HTTP-Header, der auf Server- oder CDN-Ebene gesetzt wird.
Typische Beispiele:
X-Robots-Tag: noindexsperrt die Ressource vollständig aus dem Index.X-Robots-Tag: googlebot: noindexrichtet die Anweisung gezielt an einen Crawler.X-Robots-Tag: noindex, nofollowkombiniert mehrere Direktiven in einer Headerzeile.
Der Header eignet sich besonders für verzeichnisweite Einstellungen, etwa wenn ein ganzes Verzeichnis mit PDF-Dateien von der Indexierung ausgeschlossen werden soll. Entscheidend ist dabei die Konsistenz: Steht im Meta-Tag einer HTML-Seite index, im Header aber noindex, gilt die restriktivere Anweisung. Das führt zu unerwarteten Ergebnissen, wenn niemand den Widerspruch bemerkt.
Robots-Meta-Tag und robots.txt im Vergleich
Beide Mechanismen lösen unterschiedliche Aufgaben, und genau diese Verwechslung führt in der Praxis häufig zu technischen SEO-Fehlern.
- Die robots.txt regelt den Abruf. Sie entscheidet, ob ein Crawler eine URL überhaupt besuchen darf.
- Der Meta-Tag regelt Indexierung und Darstellung. Er wirkt erst, nachdem die Seite geladen wurde.
- Eine Sperre in der robots.txt verhindert die Verarbeitung von noindex. Wird eine URL per robots.txt blockiert, liest der Crawler den Meta-Tag nicht. Die Seite kann deshalb trotz noindex-Absicht im Index bleiben.
- Für vertrauliche Inhalte ist Authentifizierung die richtige Lösung. Google weist ausdrücklich darauf hin, dass Robots-Direktiven keinen Zugriffsschutz darstellen. Sensible Daten müssen daher über Login oder Passwortschutz abgesichert werden.
Implementierung, Testen und Fehlerbehebung: Prüfliste
Eine Robots-Anweisung wirkt nur, wenn sie im tatsächlich ausgelieferten, gerenderten <head> steht und nicht nur im Quellcode-Template. Gerade bei JavaScript-gesteuerten Seiten lohnt sich ein Blick auf nachladende Inhalte für Googlebot, da dynamisch eingefügte Tags leicht übersehen werden.
Folgende Prüfschritte gehören in jeden Rollout:
- Gerenderten HTML-Code über die Entwicklertools oder einen Renderer kontrollieren, nicht nur den Serverquelltext.
- Mit
curloderhttpiedie ausgelieferten HTTP-Header direkt abfragen und auf Widersprüche prüfen. - Die URL-Prüfung in der Google Search Console nutzen, um zu sehen, welche Direktive Google tatsächlich erfasst.
- Nach jeder Änderung einen Live-Crawl auslösen und die Indexierungsberichte einige Tage später erneut kontrollieren.
CMS-Plugins setzen häufig eigene Standardwerte für Robots-Tags, die bei einem Update unbemerkt überschrieben werden können. Ein Prüfprotokoll, das jede Änderung mit Datum und Verantwortlichem dokumentiert, sorgt dafür, dass solche Regressionen nicht erst nach einem Rankingverlust auffallen.
Profi-Tipp:Binden Sie eine automatisierte CI-Prüfung ein, die bei jedem Deployment den Robots-Status kritischer URLs gegen eine definierte Liste abgleicht.
Häufige Fallstricke und Spezialfälle
Der klassische Fehler: Eine URL soll per noindex aus dem Index verschwinden, ist aber gleichzeitig in der robots.txt gesperrt. Der Crawler ruft die Seite dann nicht ab und liest das noindex nicht. Im ungünstigsten Fall bleibt die Seite indexiert, lediglich ohne Snippet.
Weitere Praxisfälle:
- indexifembedded eignet sich für Mediendateien, die in eingebetteten Kontexten erscheinen sollen, etwa Videos auf Partnerseiten, auch wenn die eigenständige Medien-URL selbst
noindexträgt. - A/B-Tests sollten laut Googles Empfehlung über
rel="canonical"konsolidiert werden statt über pauschalesnoindex, da Testvarianten sonst dauerhaft aus dem Index fallen können. - Relaunches verursachen Rankingverluste häufig durch genau diese Kombination: Staging-Sperren in der robots.txt, die nach dem Go-live vergessen werden, oder noindex-Reste aus der Entwicklungsumgebung.
Praxisbeispiele und Copy-Paste-Snippets
Drei Situationen kommen in der Praxis besonders oft vor, jede mit einer sofort einsetzbaren Lösung.
- Staging- oder Entwicklungsumgebung absichern: Den Zugriff schützt ein Passwort oder eine IP-Beschränkung. Zusätzlich verhindert
<meta name="robots" content="noindex">im Head jeder Seite, dass versehentlich freigegebene Seiten im Index landen. - PDF-Dokumente aus dem Index halten: Der Server liefert für das entsprechende Verzeichnis den Header
X-Robots-Tag: noindexaus, ganz ohne Eingriff in die Dateien selbst. - Vorschau begrenzen, Indexierung aber erlauben:
<meta name="robots" content="max-snippet:50">kürzt den Textausschnitt in den Suchergebnissen, währendnosnippetjede Vorschau unterdrückt. Die Seite selbst bleibt in beiden Fällen indexiert und rankingfähig.
Diese drei Fälle begegnen SEYBOLD in Audits besonders häufig, von der versehentlich live geschalteten Testumgebung bis zur PDF-Bibliothek, die niemand bewusst für die Suche freigegeben hat.
Praxisbeleg: SEYBOLDs Erfahrung mit Robots-Direktiven
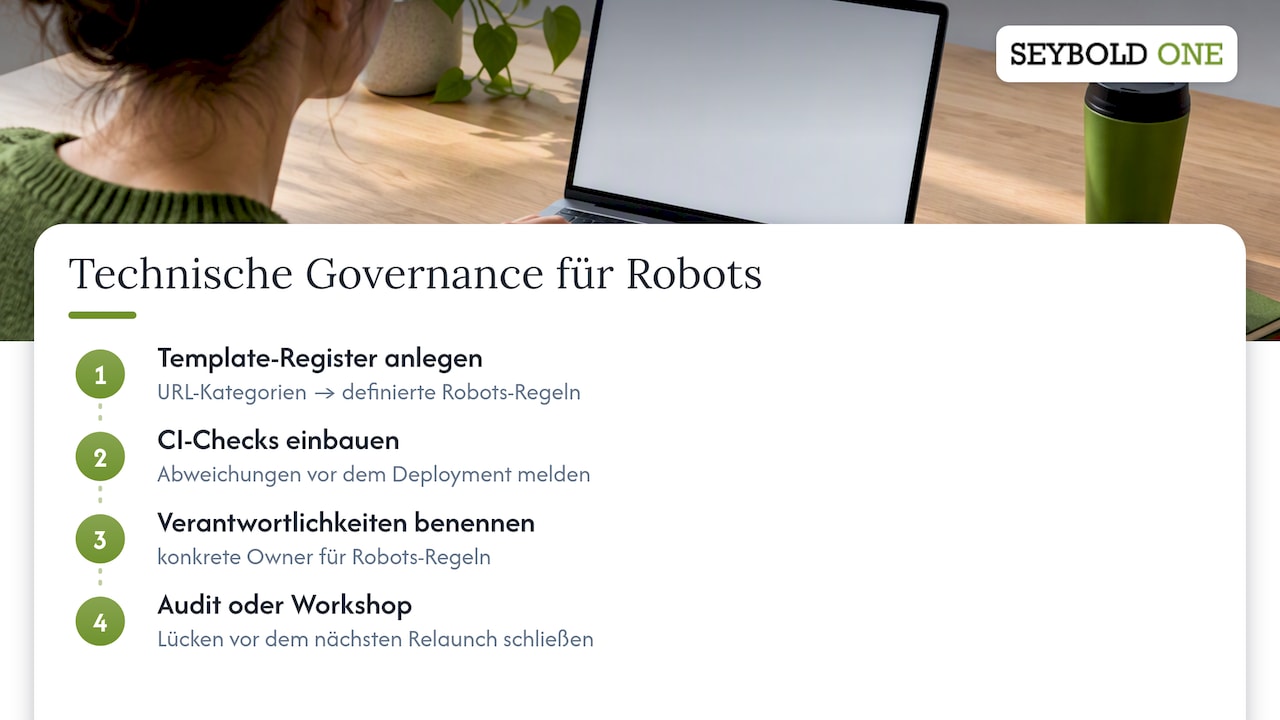
Als Agentur für Sichtbarkeitsmanagement beobachtet SEYBOLD regelmäßig, dass Rankingverluste nach einem Relaunch selten auf eine einzelne falsche Direktive zurückgehen. Häufiger fehlen klare Zuständigkeiten: Niemand dokumentiert, welches Template welchen Robots-Status setzt, und ein CMS-Update überschreibt die Regel unbemerkt.
Für Teams empfiehlt sich ein zentrales Template-Register, das jede URL-Kategorie einer definierten Robots-Regel zuordnet. Ergänzend melden CI-Checks Abweichungen vor dem Deployment. Verantwortlichkeiten sollten klar benannt sein, denn ohne Owner bleibt jede Prüfliste Theorie. Wo diese Struktur noch fehlt, schließen ein technisches Audit oder ein fokussierter Workshop die Lücken vor dem nächsten Relaunch.
Wie SEYBOLD Sie bei Robots-Direktiven unterstützt
Ein einzelner vergessener noindex-Tag oder eine widersprüchliche robots.txt-Regel kann Wochen an Sichtbarkeitsaufbau zunichtemachen. Solche Fehler fallen in Audits häufig auf, lange bevor sie als Rankingverlust sichtbar werden. Der Ansatz von SEYBOLD prüft Robots-Direktiven deshalb nicht isoliert, sondern im Zusammenhang mit Crawling, Indexierung und technischer Infrastruktur.
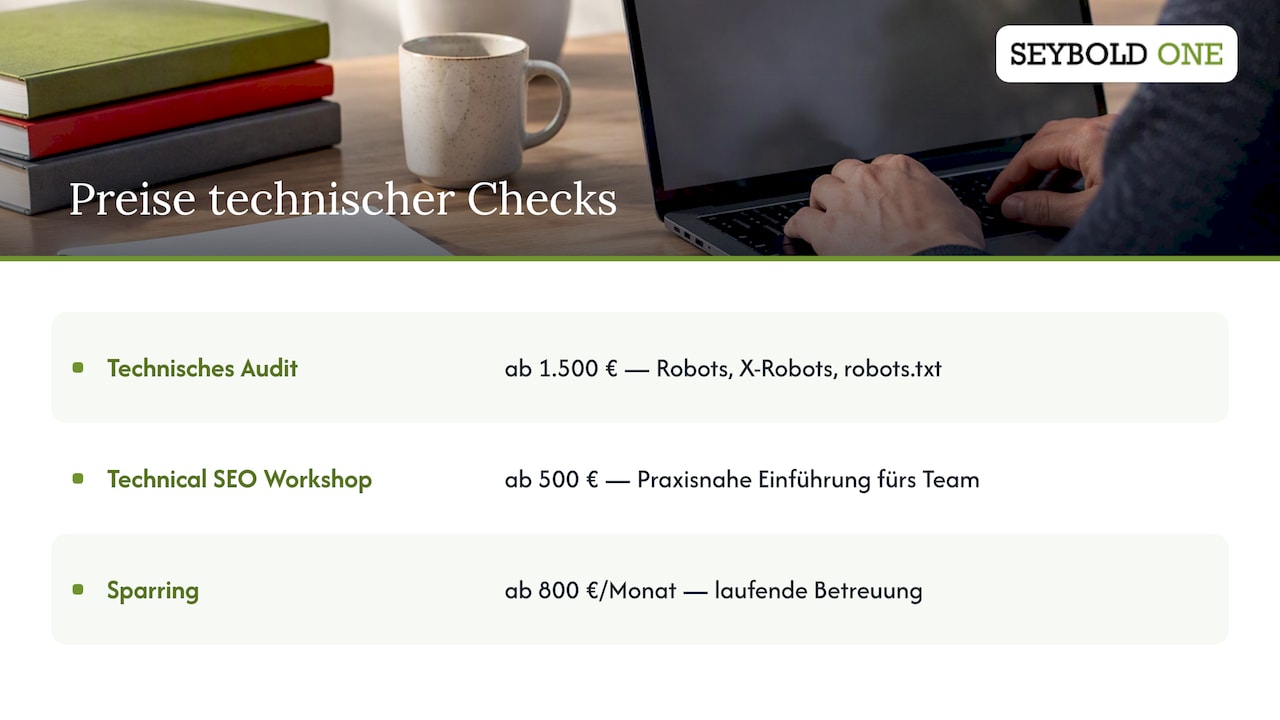
Für eine gezielte Überprüfung bietet SEYBOLD das technische Audit an, das Robots-Meta-Tags, X-Robots-Tag-Header und robots.txt-Konfiguration gemeinsam bewertet. Der Technical SEO Workshop bietet Teams einen praxisnahen Einstieg in die Umsetzung, und für die laufende Betreuung über mehrere Projekte hinweg steht das Einstiegspaket Sparring zur Verfügung. Einen Überblick über alle Beratungsleistungen und deren Preise finden Sie auf der Preisübersicht zu SEO-Leistungen.
FAQ
Was sind Robots-Meta-Tags?
Ein Robots-Meta-Tag ist eine HTML-Anweisung im <head> einer Seite, die Suchmaschinen mitteilt, ob die Seite indexiert und ob ihren Links gefolgt werden darf. Zusätzliche Werte wie nosnippet oder max-snippet steuern, wie die Seite in der Vorschau erscheint.
Wie sieht ein Robots-Meta-Tag in der Praxis aus?
Ein gängiges Beispiel ist <meta name="robots" content="noindex,follow">, das die Indexierung verhindert, aber Links weiterverfolgen lässt. Ebenso verbreitet ist <meta name="robots" content="max-snippet:50">, das die Länge des angezeigten Textausschnitts begrenzt.
Was unterscheidet robots.txt von Robots-Meta-Tags?
Die robots.txt steuert, ob ein Crawler eine URL überhaupt abrufen darf. Der Meta-Tag wirkt erst nach dem Abruf und regelt Indexierung, Linkverfolgung und Vorschau. Eine Sperre in der robots.txt kann deshalb verhindern, dass ein noindex-Tag gelesen wird.
Wann wird der X-Robots-Tag statt des Meta-Tags verwendet?
Der X-Robots-Tag kommt bei Dateien zum Einsatz, die keinen HTML-Head besitzen, etwa PDFs, Word-Dokumente oder Bilder. Er wird als HTTP-Header auf Server- oder CDN-Ebene ausgeliefert.
Funktionieren Robots-Meta-Tags noch?
Ja, Robots-Meta-Tags und der X-Robots-Tag-Header gehören weiterhin zur aktuellen Spezifikation von Google Search Central und werden von gängigen Suchmaschinen ausgewertet. Entscheidend bleibt eine fehlerfreie, widerspruchsfreie Implementierung im gerenderten Code.
Empfehlungen