Logfile‑Analyse SEO: So decken Sie Crawling‑Probleme auf
Logfile-Analyse zeigt Ihnen genau, welche URLs Googlebot wann und wie besucht hat. Daraus leiten wir konkrete Entscheidungen ab: Wo verschwendet Googlebot sein Crawl-Budget, welche technischen Änderungen wurden tatsächlich ausgerollt und wo versteckt sich problematischer Bot-Traffic. Keine Schätzung, keine Stichprobe, sondern die vollständige Aufzeichnung jeder einzelnen Anfrage an Ihren Server.
Crawling-Probleme gezielt aufdecken
SEYBOLD ONE analysiert Server-Logs, Crawling-Fehler und technische SEO-Probleme und leitet daraus priorisierte Maßnahmen für Ihre Sichtbarkeit ab.
Unverbindliche Beratung anfragenWas ist Logfile-Analyse für SEO? Nutzen und Abgrenzung
Logfile-Analyse ist die systematische Auswertung von Serverprotokollen, um zu rekonstruieren, wie Suchmaschinen-Crawler und andere Bots tatsächlich mit einer Website interagieren. Jede Zeile im Logfile ist ein echter Request, keine Modellierung und keine Hochrechnung. Das unterscheidet diese Methode fundamental von Tools wie der Google Search Console oder klassischen Crawlern, die immer nur einen Ausschnitt oder eine Simulation liefern.
Die Search Console zeigt Ihnen aggregierte Daten mit Verzögerung und oft gekappten Wertebereichen. Ein Crawl-Tool wie Screaming Frog simuliert, wie ein Bot Ihre Seite sehen könnte, besucht die Seite aber selbst. Logfiles hingegen dokumentieren, was Googlebot, Bingbot oder andere Crawler tatsächlich abgerufen haben, mit Zeitstempel und Statuscode. Das macht sie zur primären Datenquelle, wann immer es um reale Crawl-Frequenz, Crawl-Budget-Verteilung oder die Validierung technischer Änderungen nach einem Relaunch geht.
Wichtig ist dabei die Grenze der Methode: Logs zeigen Crawling-Verhalten, nicht Rankings. Wer wissen will, warum eine Seite nicht rankt, braucht zusätzlich Rankingdaten und Inhaltsanalysen. Logfiles beantworten eine andere, oft unterschätzte Frage: Erreicht Googlebot die Seiten überhaupt, die ranken sollen, und wie oft?
Anatomie eines Log-Eintrags und übliche Formate
Ein einzelner Log-Eintrag wirkt auf den ersten Blick kryptisch, enthält aber alle Informationen, die für technisches SEO relevant sind. Die Apache-Dokumentation zu mod_log_config beschreibt das Standardformat mit Feldern wie Zeitstempel, angeforderte URL, Statuscode und übertragene Bytes. Bei nginx regeln vergleichbare Variablen das Logging, wie die nginx-Dokumentation zum log-Modul zeigt.
Für die SEO-Analyse sind folgende Felder entscheidend:
- Timestamp: Zeitpunkt des Requests, wichtig für Crawl-Frequenz-Muster über Tage und Wochen.
- IP-Adresse: Grundlage für die Verifizierung, ob ein Bot wirklich von Google stammt.
- User-Agent: Gibt an, welcher Client den Request gestellt hat, etwa Googlebot oder ein SEO-Tool.
- HTTP-Methode: Meist GET, gelegentlich HEAD oder POST, relevant bei API-nahen Strukturen.
- Statuscode: Zeigt, ob eine Anfrage erfolgreich war (200), umgeleitet wurde (301/302) oder fehlschlug (404/5xx).
- angeforderte URL: Die exakte Ressource, die abgerufen wurde, inklusive Parametern.
- Response-Time: Wie lange der Server für die Antwort brauchte, ein Signal für Rendering- und Performance-Probleme.
- übertragene Bytes: Hilft, besonders schwere Ressourcen zu identifizieren.
Ein typischer Apache-Eintrag könnte so aussehen: 66.249.66.1 - - [12/Mar/2026:10:15:32 +0100] "GET /produkte/schuhe HTTP/1.1" 200 5423. Bei nginx sieht die Struktur ähnlich aus, nutzt aber eigene Variablennamen im log_format. Server-Logs unterscheiden sich zudem von CDN- oder Load-Balancer-Logs: Letztere protokollieren auch die Anfragen, die den Ursprungsserver gar nicht erreichen, weil ein Cache sie bereits am Edge beantwortet hat, die Server-Logs dagegen nur, was tatsächlich beim Ursprungsserver ankommt. Für eine vollständige Sicht auf das Crawling-Verhalten braucht man daher im Zweifel beide Quellen.
Logfiles sammeln, aufbereiten und datenschutzkonform speichern
Bevor eine Analyse beginnt, müssen Logs aus allen relevanten Quellen zusammengeführt werden. Reine Server-Logs erfassen alles, was den Ursprungsserver erreicht, CDN-Logs dagegen auch die Anfragen, die am Edge beantwortet wurden und sonst unsichtbar blieben. Wer ein CDN wie Cloudflare oder Fastly einsetzt, sollte beide Ebenen einbeziehen, sonst fehlt ein erheblicher Teil des Bot-Traffics in der Auswertung.
Bei der Aufbewahrung empfiehlt sich ein differenzierter Blick: Für reine SEO-Analysen reicht in der Praxis ein Zeitraum von zwei bis drei Monaten aus, um saisonale Muster und Relaunch-Effekte zu erkennen. Als Orientierung für die Speicherdauer hilft ein Blick auf öffentliche Stellen: Nach den Datenschutzhinweisen der Bundesregierung wird die IP-Adresse im Logfile der Loadbalancer erfasst, um den Betrieb sicherzustellen und vor Angriffen zu schützen, die Logfiles werden nach 90 Tagen gelöscht. Diese Frist ist eine sinnvolle Obergrenze, auch wenn der SEO-Anwendungsfall etwas andere Prioritäten setzt.
Die Vorbereitung der Rohdaten folgt typischerweise diesen Schritten:
- Zeitzonen vereinheitlichen, damit Crawl-Muster über mehrere Serverstandorte vergleichbar werden.
- IP-Adressen kürzen oder pseudonymisieren, bevor Daten in ein Analysesystem geladen werden.
- Logformate normalisieren, wenn Apache-, nginx- und CDN-Logs unterschiedliche Feldreihenfolgen nutzen.
- Redundante oder irrelevante Einträge filtern, etwa interne Health-Checks.
- Export in ein strukturiertes Format wie CSV oder Parquet für die weitere Verarbeitung.
Profi-Tipp:Speichern Sie Rohlogs komprimiert und getrennt von den aggregierten Auswertungen, so bleibt die Löschfrist für personenbezogene Daten einhaltbar, ohne dass die Analyseergebnisse verloren gehen.
Praktische Parsing-Werkzeuge und Workflows für die Auswertung
Für eine erste, schnelle Sichtung reichen oft einfache Bordmittel. Ein kurzes Shell-Skript mit grep und awk filtert zum Beispiel alle Zeilen mit dem User-Agent „Googlebot“ heraus und zählt Statuscodes pro Tag. Python-Bibliotheken wie pandas eignen sich gut, um solche Ad-hoc-Auswertungen in ein paar Zeilen Code zu verwandeln, etwa um Crawl-Frequenz pro URL-Verzeichnis zu gruppieren.
Für größere Websites mit mehreren Millionen Zeilen pro Tag stoßen Shell-Skripte schnell an Grenzen. Hier lohnt sich eine robuste Pipeline, etwa mit Logstash zur Aufnahme der Rohdaten, Elasticsearch zur Indexierung und einem Dashboard zur Visualisierung. Alternativ lassen sich Logs in Parquet-Dateien konvertieren und mit verteilten Abfrage-Engines auswerten, was sich besonders bei sehr großen Datenmengen auszahlt.
Ein Aspekt, der in der Toolauswahl oft zu kurz kommt, ist die datenschutzfreundliche Webanalyse als Ergänzung zur reinen Logfile-Auswertung. Matomo lässt sich, anders als viele Cloud-Analysetools, on-premise betreiben, wobei laut den Hinweisen der Datenschutzkonferenz zu Google Analytics eine Kürzung der IP-Adresse allein nicht automatisch von DSGVO-Pflichten entbindet. Wer Matomo so konfiguriert, dass nur ein Teil der IP-Adresse gespeichert wird und keine Daten an Drittanbieter fließen, bleibt näher an der eigenen Kontrolle über die Daten als mit rein cloudbasierten Lösungen.
Für die laufende Arbeit zahlt sich Automatisierung aus:
- Tägliche ETL-Jobs, die neue Logdateien einlesen, bereinigen und in die Analyseumgebung laden.
- Vordefinierte Aggregationen pro URL-Segment, Statuscode und Bot-Typ, die sich täglich aktualisieren.
- Gespeicherte Dashboards, die Abweichungen vom Normalzustand automatisch markieren, etwa einen plötzlichen Anstieg an 5xx-Fehlern.
- Exportroutinen, die aggregierte, bereits anonymisierte Daten an SEO-Teams weiterleiten, ohne dass diese Zugriff auf Rohdaten mit IP-Adressen benötigen.
Wer sich zusätzlich mit der Auswahl von SEO-Tools im weiteren Sinne beschäftigt, findet in einem Vergleich von Semrush-Alternativen für Deutschland eine ergänzende Einordnung, welche Software sich für welchen Anwendungsfall eignet.
Profi-Tipp:Bauen Sie die Logfile-Pipeline so, dass sie unabhängig von einem einzelnen Analysetool läuft. So wechseln Sie später die Visualisierungsschicht, ohne die gesamte Datenaufbereitung neu aufzusetzen.
Welche Fragen stellen Sie an die Logs und was bedeuten die Antworten?
Eine Logfile-Analyse beginnt nicht mit Zahlen, sondern mit präzisen Fragen. Wer ungerichtet durch Millionen Zeilen scrollt, findet selten die relevanten Muster. Sinnvoller ist ein festes Set an Analyseachsen, das sich auf jede Website anwenden lässt.
Die erste Frage betrifft die Echtheit der Crawler. Ein User-Agent allein beweist nichts, denn er lässt sich beliebig fälschen. Verlässlicher ist ein Reverse-DNS-Lookup der IP-Adresse, kombiniert mit einem Forward-Lookup zur Bestätigung, ein Verfahren, das Spoofing zuverlässig entlarvt. Wer feststellt, dass angebliche Googlebot-Requests tatsächlich aus unbekannten Rechenzentren stammen, hat ein handfestes Indiz für Bot-Traffic, der sich nur als Suchmaschine ausgibt. Mehr zum Umgang mit solchem Bot-Traffic und der Identifikation gefälschter User-Agents findet sich in unserem vertiefenden Beitrag.
Die zweite Analyseachse ist die Crawl-Frequenz pro Segment. Statt jede URL einzeln zu betrachten, gruppieren wir nach URL-Verzeichnis oder Content-Typ, etwa Produktseiten, Kategorieseiten oder Blogartikel. So wird sichtbar, ob Googlebot Zeit auf Seiten verbringt, die businessrelevant sind, oder ob ein Großteil der Besuche in irrelevante Parameter-URLs fließt.
Drittens lohnt sich die Statuscode-Verteilung je Segment. Ein hoher Anteil an 404-Antworten in einem bestimmten Verzeichnis deutet auf verwaiste interne Links hin, Hinweise zur systematischen Behebung solcher Probleme liefert unser Beitrag zum Umgang mit 404-Problemen in der Search Console.
Weitere zentrale Checks:
- Response-Time pro URL-Typ: Langsame Antwortzeiten korrelieren oft mit reduzierter Crawl-Tiefe.
- Ressourcen-Fetchs: Werden CSS- und JS-Dateien überhaupt abgerufen, oder blockiert eine robots.txt das Rendering?
- Verteilung über Subdomains: Bekommt eine wichtige Subdomain überhaupt ausreichend Besuche?
Von der Analyse zur Aktion: Priorisieren, umsetzen, validieren
Eine Analyse ohne Priorisierung bleibt akademisch. Wir sortieren Befunde nach dem Verhältnis von Wirkung zu Aufwand: Ein Problem, das viel Crawl-Budget bindet und sich mit einer einzigen Regel beheben lässt, steht ganz oben auf der Liste. Ein Problem mit geringer Wirkung, das aber einen kompletten Architekturumbau erfordert, wandert nach hinten.
Typische Kandidaten für schnelle Priorität sind wiederkehrende 5xx-Fehler auf bestimmten Templates, häufig angefragte JavaScript-Ressourcen, die eigentlich gecacht werden sollten, und Redirect-Schleifen, die Crawler in Endlosketten schicken. Solche Befunde übersetzen wir in konkrete Tickets: Für Entwickler mit exakter URL, Statuscode und Häufigkeit, für das SEO-Team mit der erwarteten Auswirkung auf Crawl-Budget und Indexierung.
Die Umsetzung folgt einem klaren Ablauf:
- Befund dokumentieren mit Beispiel-URLs und Zeitraum der Beobachtung.
- Fix spezifizieren und an das Entwicklungsteam übergeben.
- Nach dem Rollout erneut Logs ziehen und gezielt die betroffenen URLs prüfen.
- Bestätigen, dass der Statuscode oder die Response-Time sich wie erwartet verändert hat.
- Ein Monitoring einrichten, das bei erneutem Auftreten automatisch einen Alert auslöst.
Gerade bei Relaunches ist dieser Validierungsschritt über Logs oft die einzige verlässliche Bestätigung, dass Googlebot die neue Struktur tatsächlich so crawlt wie geplant, und nicht nur, dass ein Crawl-Tool es theoretisch so sehen würde.
Profi-Tipp:Setzen Sie feste Alert-Schwellen, etwa einen Anteil von 5xx-Antworten über einem bestimmten Prozentsatz pro Tag, damit Regressionsprobleme auffallen, bevor sie sich auf die Rankings auswirken.
Datenschutz-Praxis bei Logfile-Analysen: DSGVO und TDDDG im Alltag
Logfiles enthalten mit der IP-Adresse ein personenbezogenes Datum, auch wenn der Absender ein Bot ist, denn die gleiche Infrastruktur protokolliert in der Regel auch menschlichen Traffic. Nach den Datenschutzhinweisen der Bundesregierung umfassen typische Logfelder Browsertyp, Betriebssystem und IP-Adresse, und genau diese Kombination macht eine durchdachte Aufbewahrungs- und Löschpraxis notwendig.
Die Bundesregierung löscht Logfiles nach 90 Tagen, vor allem zur Betriebssicherung und zum Schutz vor Angriffen. Für SEO-Zwecke genügen in der Praxis meist zwei bis drei Monate, da saisonale Crawl-Muster sich in diesem Zeitraum zuverlässig abzeichnen.
Konkrete technische Maßnahmen, die sich in jedem Setup umsetzen lassen:
- IP-Adressen kürzen oder pseudonymisieren, bevor Logs in ein Analysesystem geladen werden.
- Eine klare Aufbewahrungs-Policy festlegen und im Verzeichnis der Verarbeitungstätigkeiten dokumentieren.
- Zugriff auf Rohlogs auf wenige Personen beschränken, aggregierte Reports breiter verteilen.
- Bei der Tool-Auswahl zwischen On-Premise-Lösungen und Cloud-Diensten abwägen, wobei On-Premise mehr Kontrolle über Speicherort und Löschfristen bietet.
Wichtig ist, dass die reine Kürzung der IP-Adresse laut den Hinweisen der Datenschutzkonferenz zu Google Analytics nicht automatisch von allen DSGVO-Pflichten entbindet. Wer Logdaten mit Nutzerendgeräten verknüpft oder Tracking-Funktionen ergänzt, sollte zusätzlich die Consent-Anforderungen des TDDDG prüfen, bevor ein Tool produktiv geht.
Forensische Praxis: Checkliste und methodische Hinweise aus der Agenturarbeit
In der forensischen Arbeit mit vielen Kunden hat sich ein festes Set an Prüfpunkten etabliert, das sich auf fast jede Logfile-Analyse übertragen lässt. Am Anfang steht die Bildung von Crawl-Clustern: URLs werden nach Verzeichnis, Template oder Content-Typ gruppiert, um Muster zu erkennen, die bei Einzelbetrachtung untergehen würden.
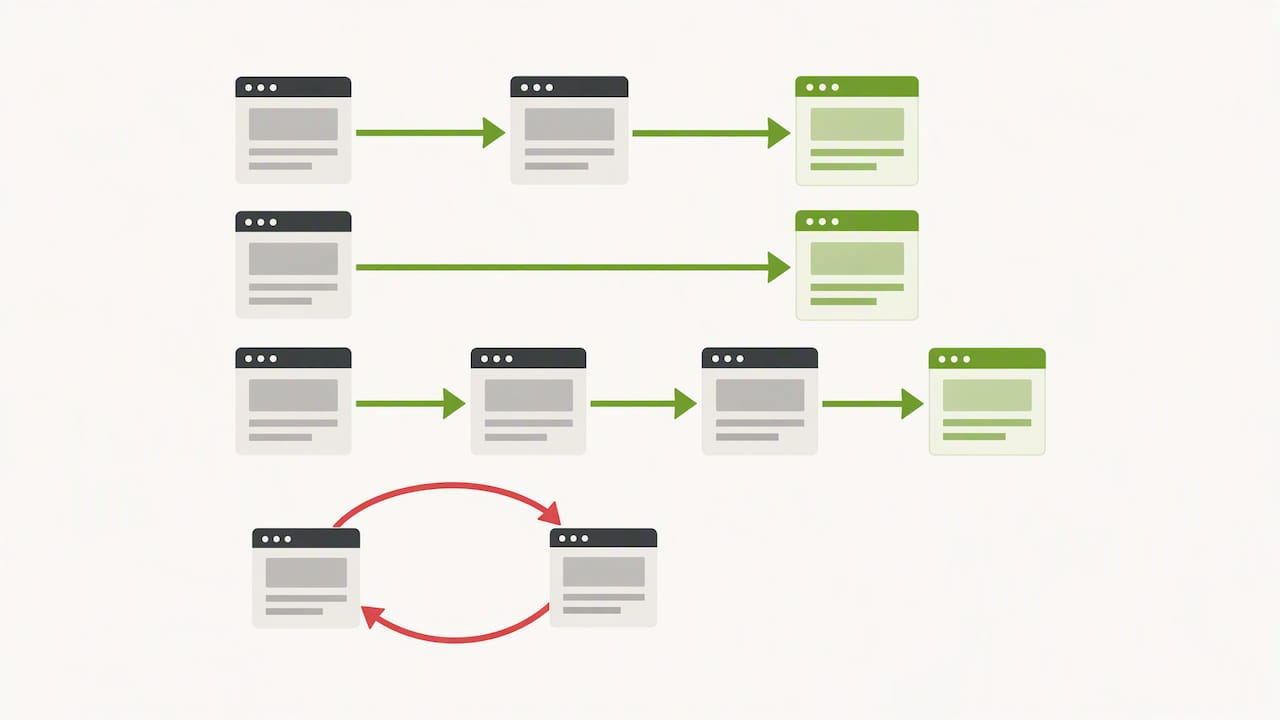
Direkt danach folgt die Prüfung von Redirect-Ketten, denn mehrfach verschachtelte Weiterleitungen sind einer der häufigsten Gründe für verschwendetes Crawl-Budget. Ebenso regelmäßig zeigen sich Indexierungs-Lücken: Seiten, die zwar im Sitemap-Feed stehen, aber von Googlebot kaum besucht werden, ein klares Signal für interne Verlinkungsprobleme.
Ein dritter fester Punkt ist die Erstellung von Bot-Profilen, also die Zuordnung, welche Crawler welche Bereiche einer Website bevorzugen, und ob sich daraus Rückschlüsse auf technische Barrieren ziehen lassen. Diese Methodik basiert auf einem Ansatz des Sichtbarkeitsmanagements, der nach eigenen Standards gemäß DIN SPEC 33461 entwickelt wurde.
Wer eine solche forensische Prüfung für die eigene Website durchführen möchte, findet den passenden nächsten Schritt in unserem forensischen Audit oder in einem gezielten Workshop.
Typische Fallstudien und Praxisbeispiele aus der Logfile-Analyse
In der Agenturpraxis wiederholen sich bestimmte Muster über verschiedene Branchen hinweg, auch wenn jede Website ihre eigenen Besonderheiten hat. Ein wiederkehrendes Szenario betrifft Online-Shops mit stark facettierter Navigation: Filterkombinationen erzeugen tausende URL-Varianten, die Googlebot brav crawlt, ohne dass diese Seiten jemals ranken sollen. Die Logfile-Analyse macht in solchen Fällen sichtbar, welcher Anteil des Crawl-Budgets in diese Sackgassen fließt, oft ein überraschend großer.
Ein zweites häufiges Muster zeigt sich nach Relaunches. Neue URL-Strukturen werden angelegt, alte URLs sollen per 301 weiterleiten, doch in den Logs taucht dann auf, dass Googlebot über Wochen noch die alten Pfade anfragt und teilweise in Redirect-Schleifen gerät, weil eine Weiterleitungsregel unvollständig implementiert wurde. Ohne Logfile-Abgleich bleibt dieser Fehler oft monatelang unentdeckt, weil die Website für menschliche Besucher ganz normal funktioniert.
Ein drittes Muster betrifft internationale Websites mit mehreren Sprachversionen. Hier zeigt die Segmentierung nach Sprachordner häufig, dass eine bestimmte Sprachversion deutlich seltener gecrawlt wird als die anderen, meist ein Hinweis auf fehlende interne Verlinkung oder eine fehlerhafte hreflang-Implementierung. In allen drei Fällen liefert die Logfile-Analyse den Beweis, nicht nur die Vermutung, und genau das macht sie für die Priorisierung von Entwicklungsressourcen so wertvoll.
Ungewöhnliche Log-Patterns richtig lesen: Crawling-Fehler und Bot-Angriffe
Nicht jedes auffällige Muster in den Logs ist ein SEO-Problem, aber jedes verdient einen genauen Blick. Ein plötzlicher, massiver Anstieg an Requests von einer einzelnen IP-Range deutet häufiger auf einen Scraping-Versuch oder eine automatisierte Attacke hin als auf legitimen Suchmaschinen-Traffic. Hier hilft der Abgleich mit bekannten Googlebot-IP-Bereichen über Reverse- und Forward-DNS, um echten von vorgetäuschtem Bot-Traffic zu trennen.
Ein anderes Muster ist der schleichende Anstieg von 5xx-Fehlern, oft ein Vorbote von Serverproblemen unter Last, die noch nicht groß genug sind, um Monitoring-Alarme auszulösen, aber bereits beginnen, Crawler auszubremsen. Wiederkehrende Timeouts bei bestimmten Templates sind ein ähnliches Frühwarnsignal, besonders wenn sie mit einem bestimmten Pluginset oder einer bestimmten Datenbankabfrage korrelieren.
Auch Redirect-Schleifen hinterlassen ein charakteristisches Muster: dieselbe IP fragt innerhalb kurzer Zeit dieselbe URL-Kette mehrfach an, ohne jemals einen finalen 200er zu erhalten. Und ein auffällig hoher Anteil an Requests auf nicht existierende, zufällig wirkende Pfade deutet meist auf automatisiertes Fuzzing oder Sicherheits-Scans hin, nicht auf ein SEO-Thema im engeren Sinn, aber dennoch ein Befund, der an die technische Abteilung weitergereicht werden sollte. Wer solche Muster systematisch erfasst, erkennt Probleme oft Wochen, bevor sie sich in Rankingverlusten niederschlagen.
Was die Logfile-Analyse in der Praxis wirklich bringt
Die meisten SEO-Teams überschätzen, was Crawl-Tools und die Search Console über das tatsächliche Bot-Verhalten verraten, und unterschätzen gleichzeitig, wie viel Crawl-Budget in irrelevanten URL-Sackgassen verschwindet. Eine Logfile-Analyse ist kein nettes Extra für große Websites, sondern oft der einzige Weg, diese blinden Flecken überhaupt zu sehen.
Was mich an dieser Methode überzeugt, ist ihre Nüchternheit: Sie liefert keine Meinung, sondern Fakten über das, was tatsächlich passiert ist. Wer regelmäßig in die Logs schaut, entwickelt nach kurzer Zeit ein Gefühl dafür, wo in der eigenen Infrastruktur die größten Hebel liegen, oft ganz andere als vermutet.
Mein konkreter Rat: Planen Sie keine einmalige Analyse, sondern ein 14-Tage-Audit mit klarem Startpunkt, in dem Sie Logs sammeln, Muster clustern und mindestens drei priorisierte Befunde in Tickets überführen. Diese Disziplin bringt mehr als jede einmalige Tiefenanalyse ohne Folgeprozess.
Technische Audits und forensische Analysen für Ihre Logfile-Auswertung
Wer die in diesem Beitrag beschriebenen Schritte selbst umsetzen will, aber Zeit oder Tooling fehlt, muss nicht bei null anfangen. Wir übernehmen die komplette Aufbereitung und Interpretation Ihrer Server-Logs und liefern am Ende keine Rohdatentabelle, sondern eine priorisierte Liste konkreter Maßnahmen.
Je nach Ausgangslage passen unterschiedliche Leistungen:
- Ein technisches Audit für 1.500 bis 3.500 Euro einmalig deckt Crawling- und Indexierungsprobleme systematisch auf.
- Ein forensisches Audit für 1.500 bis 5.500 Euro einmalig eignet sich, wenn ein plötzlicher Rankingverlust oder eine vermutete Google-Abstrafung im Raum steht.
- Eine Relaunch-Absicherung ab 1.500 Euro einmalig validiert über Logfile-Abgleich, dass eine neue Struktur so gecrawlt wird wie geplant.
- Unser Technical SEO Workshop ab 500 Euro einmalig vermittelt Ihrem Team die Methodik, um Logfile-Analysen künftig selbst durchzuführen.
Alle Leistungen und Preise im Detail finden sich auf unserer Seite zu den SEO-Kosten, wo Sie auch direkt eine Einschätzung für Ihr Projekt anfragen können.
FAQ
Gibt es ein kostenloses SEO-Analysetool?
Ja, für erste Logfile-Auswertungen reichen oft kostenlose Bordmittel wie Shell-Skripte oder Python-Bibliotheken völlig aus, ergänzt durch kostenlose Crawler für den Abgleich. Eine Übersicht über kostenlose SEO-Tools zeigt, welche Werkzeuge sich für welchen Einstiegspunkt eignen.
Welcher SEO-Score ist gut?
Ein pauschaler SEO-Score sagt wenig aus, da Tools unterschiedliche Kriterien und Gewichtungen verwenden. Aussagekräftiger ist ein Blick auf konkrete technische Kennzahlen aus den Logs, etwa den Anteil erfolgreicher Requests oder die Crawl-Frequenz auf geschäftskritischen Seiten.
Ist SEO noch sinnvoll?
Ja, solange Suchmaschinen der zentrale Einstiegspunkt für Informationssuche bleiben, bleibt auch die technische Optimierung des Crawlings relevant. Logfile-Analyse zeigt dabei besonders deutlich, dass viele Sichtbarkeitsprobleme nicht an Inhalten, sondern an technischer Erreichbarkeit für Crawler scheitern.
Was bedeutet SEO-Analyse?
Eine SEO-Analyse untersucht, wie gut eine Website für Suchmaschinen auffindbar und bewertbar ist, meist über technische, inhaltliche und strukturelle Kriterien. Die Logfile-Analyse ist dabei ein spezialisierter Teilbereich, der sich auf das tatsächliche Crawling-Verhalten von Bots konzentriert statt auf Inhalte oder Rankings.
Quellen
- Datenschutzhinweis / Datenschutzerklärung – Bundesregierung
- Hinweise zum Einsatz von Google Analytics — Datenschutzkonferenz
- Apache Module mod_log_config — Dokumentation
- ngx_http_log_module — nginx Documentation
Empfehlungen